
Valutare i Large Language Models (LLM) è fondamentale per consumatori e imprese, ma senza benchmark affidabili è quasi impossibile capire quale progresso abbia compiuto un modello nelle versioni recenti o come si posizioni rispetto ai concorrenti.
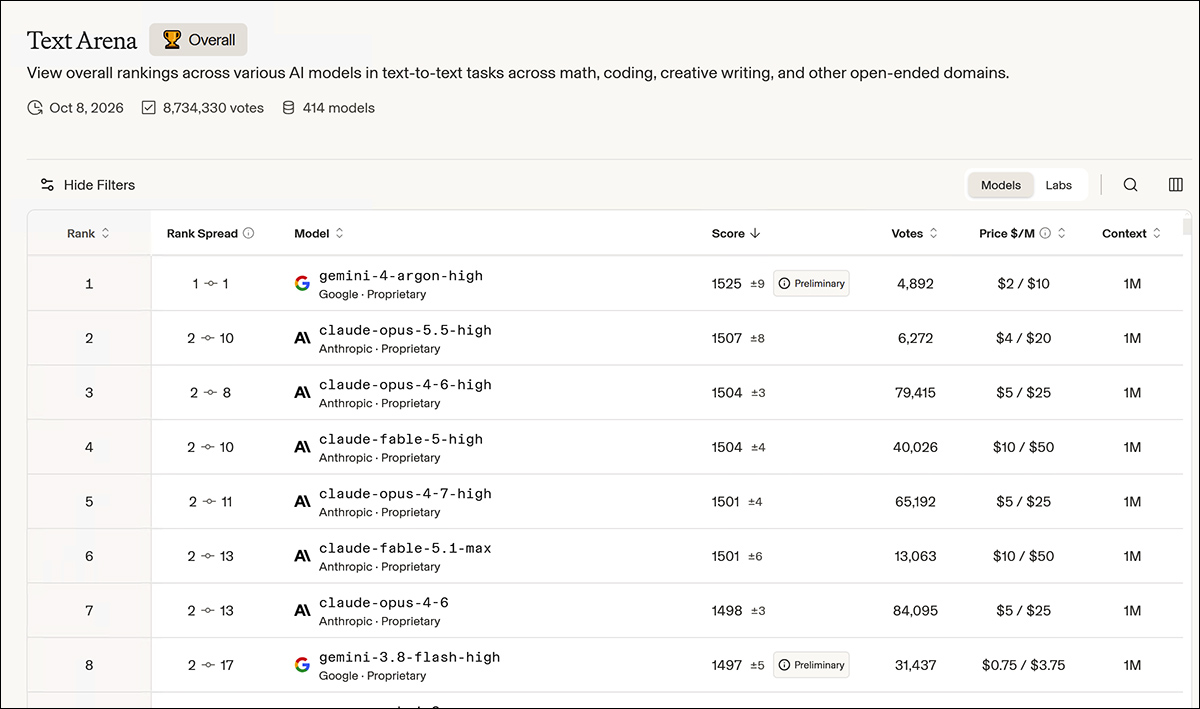
La classifica influente dei LLM su arena.ai. Fonte
Poiché i LLM sono non deterministici – non produrranno sempre output coerenti dato lo stesso input – la valutazione è intrinsecamente complessa. Anche quando ricercatori usano prompt identici, impostazioni di modello e set di benchmark uniformi, differenze apparentemente minori nell’ambiente di esecuzione possono produrre risposte diverse e alterare significativamente i punteggi di performance.
Variabili già note
Fattori come la configurazione hardware, la precisione numerica, la dimensione del batch di inferenza e persino l’ordine delle risposte a scelta multipla hanno dimostrato di influenzare i risultati dei benchmark. Queste variabili possono essere controllate o quantificate, ma rimangono comunque una fonte di margine di errore da tenere in considerazione.
Una nuova fonte di non‑determinismo: la data corrente
Secondo un recente articolo frutto di una collaborazione tra Germania, Messico e USA, la data odierna viene inserita automaticamente e in modo nascosto nei prompt di sistema di tutti i modelli all’avanguardia e di molte implementazioni di modelli a peso aperto. Questa pratica rende la riproducibilità quasi impossibile.
Citazione chiave: “Identifichiamo una fonte critica, spesso trascurata, di non‑determinismo nella valutazione dei LLM: l’iniezione nascosta della data corrente nei prompt di sistema.”
Lo studio ha analizzato nove modelli, sei dataset e quattro compiti, mostrando che i metadati dinamici alterano le prestazioni e rimescolano le classifiche, superando la varianza introdotta da altri fattori di sistema come la dimensione del batch o la precisione numerica.
Impatto sui diversi compiti
- Domande a scelta multipla: variazioni fino al 6%.
- Ragionamento matematico: variazioni fino al 14%.
- Generazione di codice: variazioni fino al 7%.
- Traduzione automatica: fluttuazioni significative, seppur non quantificate nello studio.
Fornire risposte di esempio e ragionamento passo passo, una tecnica generalmente utile per migliorare la coerenza, ha in realtà peggiorato il problema.
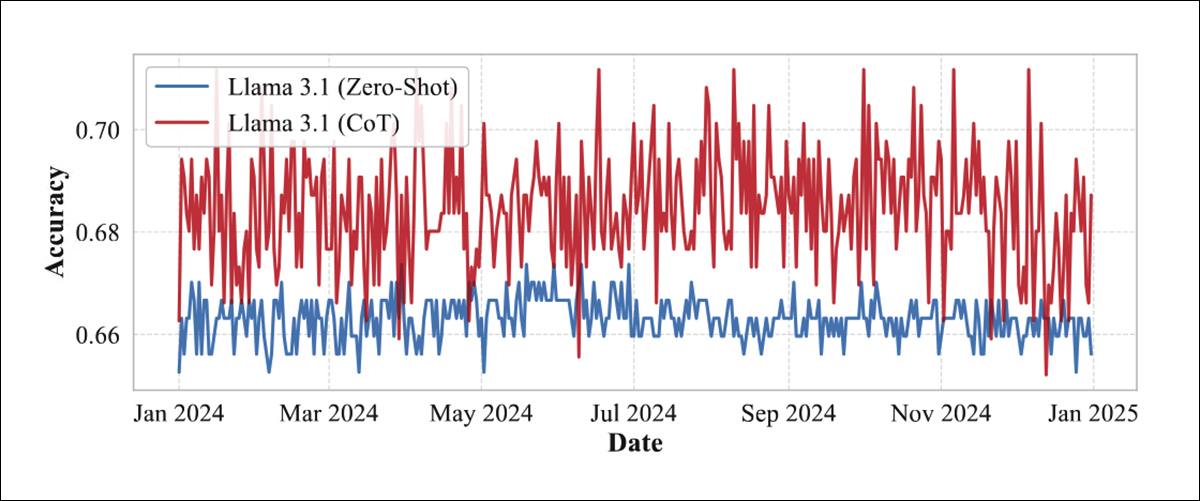
Fluttuazioni di accuratezza su date diverse nel 2024 per Llama 3.1 (8B) sul benchmark MMLU. Il ragionamento passo passo (rosso) produce una variabilità sostanzialmente maggiore rispetto alle risposte dirette (blu), dimostrando come il prompting a catena di pensiero amplifichi la sensibilità alla data. Fonte
Modelli proprietari non sono immuni
L’effetto è stato riscontrato anche in modelli proprietari. GPT‑5.1, ad esempio, ha mostrato fluttuazioni di accuratezza fino al 4% su tre benchmark a scelta multipla durante una settimana di test a dicembre 2025, nonostante l’uso di un prompt di sistema vuoto, la disattivazione del ragionamento passo passo e la temperatura impostata a zero.
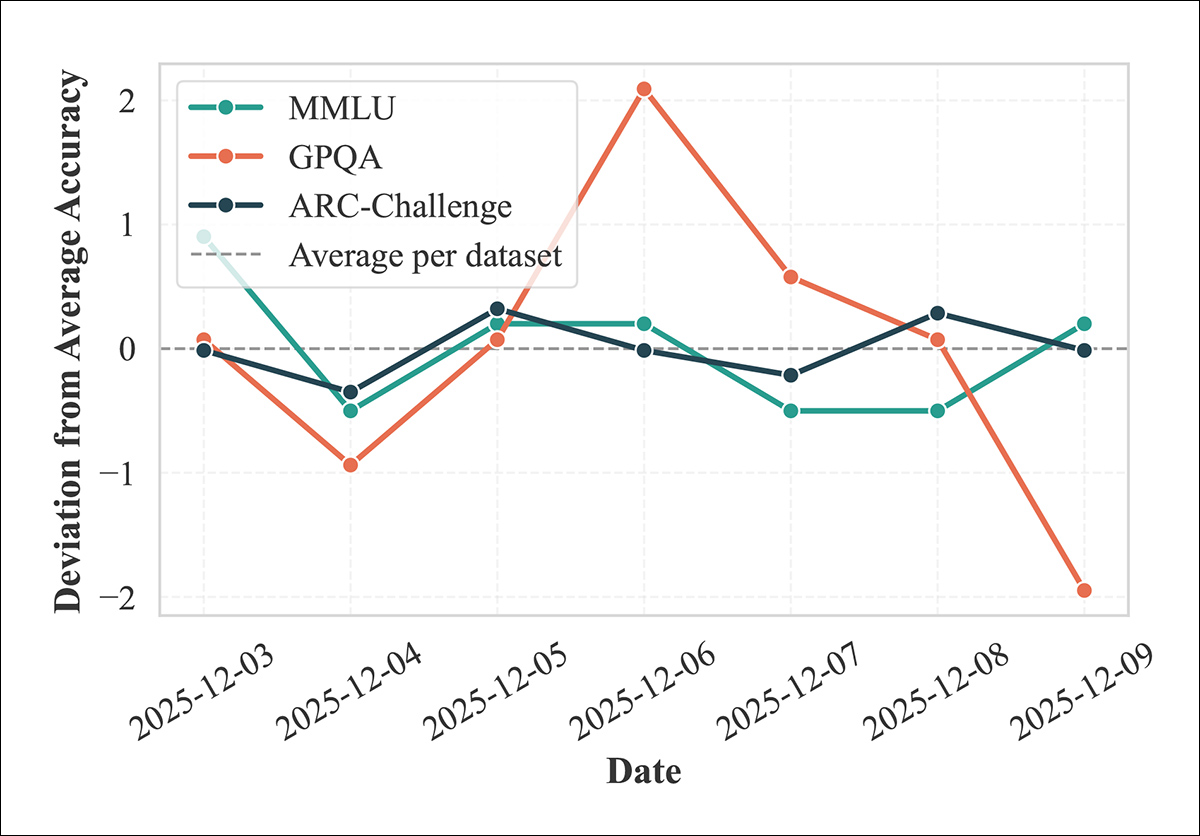
L'accuratezza di GPT-5.1 è fluttuata su sette giorni consecutivi a dicembre 2025, nonostante prompt utente e impostazioni del modello identici. La variazione più ampia si è verificata su GPQA (arancione), raggiungendo quattro punti percentuali tra il giorno migliore e quello peggiore. Fonte
Raccomandazioni dei ricercatori
I ricercatori propongono tre possibili strategie:
- Rimuovere la data dai prompt di sistema dove possibile.
- Fissare la data a un valore costante e documentarla nella configurazione del benchmark.
- Esplicitare il prompt di sistema in modo che gli utenti siano consapevoli di eventuali metadati dinamici.
Tuttavia, gli autori sottolineano che la sensibilità alla data potrebbe essere radicata nel processo di fine‑tuning supervisionato (SFT) e nell’apprendimento per rinforzo dal feedback umano (RLHF), rendendo il modello fragile a qualsiasi lieve modifica del prompt di sistema.
Altri esperimenti
Per capire l’entità dell’effetto, i ricercatori hanno testato sei diverse formulazioni del prompt di sistema, riscontrando variazioni di accuratezza pari a 0,78%, quasi identiche a quelle causate dalla sola variazione della data. Questo dimostra che la data ha un impatto comparabile a quello della deliberata “prompt engineering”.
Altri metodi di mitigazione includono:
- Few‑shot learning con cinque risposte di esempio prima della risposta finale: la variazione media è scesa dal 2,52% al 2,27%, ma il problema persiste.
- Modifiche all’hardware GPU, alla dimensione del batch, alla precisione numerica e all’ordine delle risposte: gli effetti più rilevanti sono stati osservati nell’ordine delle risposte e nella formulazione del prompt, entrambi comparabili all’influenza della data.
Perché la data è inserita?
È ragionevole aspettarsi che un LLM comprenda la data fin dall’inizio di una conversazione, ma non vi è alcuna ragione esplicita per includerla nel prompt di sistema, che è la “rubrica invisibile” che impone guardrails e condiziona i comportamenti del modello in modi inaccessibili all’utente. Un’alternativa più trasparente sarebbe consentire al modello di effettuare una chiamata RAG di pochi byte per acquisire la data più recente, anziché hard‑codificarla internamente.
Conseguenze per la community
Se la data corrente continua a influenzare i benchmark, i risultati pubblicati oggi potrebbero non essere più validi domani, minando la fiducia nella letteratura di IA e complicando le decisioni di investimento. Le organizzazioni che pubblicano classifiche – come arena.ai o leaderboard di altri provider – dovranno rivedere le loro metodologie, includendo la data come parametro di configurazione o rimuovendola del tutto.
Prospettive future
Il problema evidenzia la necessità di standard più rigorosi per la definizione dei prompt di sistema e la documentazione delle condizioni di esecuzione. Solo garantendo trasparenza su ogni variabile – compresa la data – sarà possibile confrontare in modo equo i modelli, valutare progressi reali e mantenere la credibilità dei benchmark a lungo termine.